Русский искусственный интеллект: история обучения первой отечественной языковой модели
В октябре 2020 года Сбер открыл доступ к ruGPT-3 Large — русскоязычной генеративной модели на 760 млн параметров. Обучение проходило на суперкомпьютере «Кристофари».
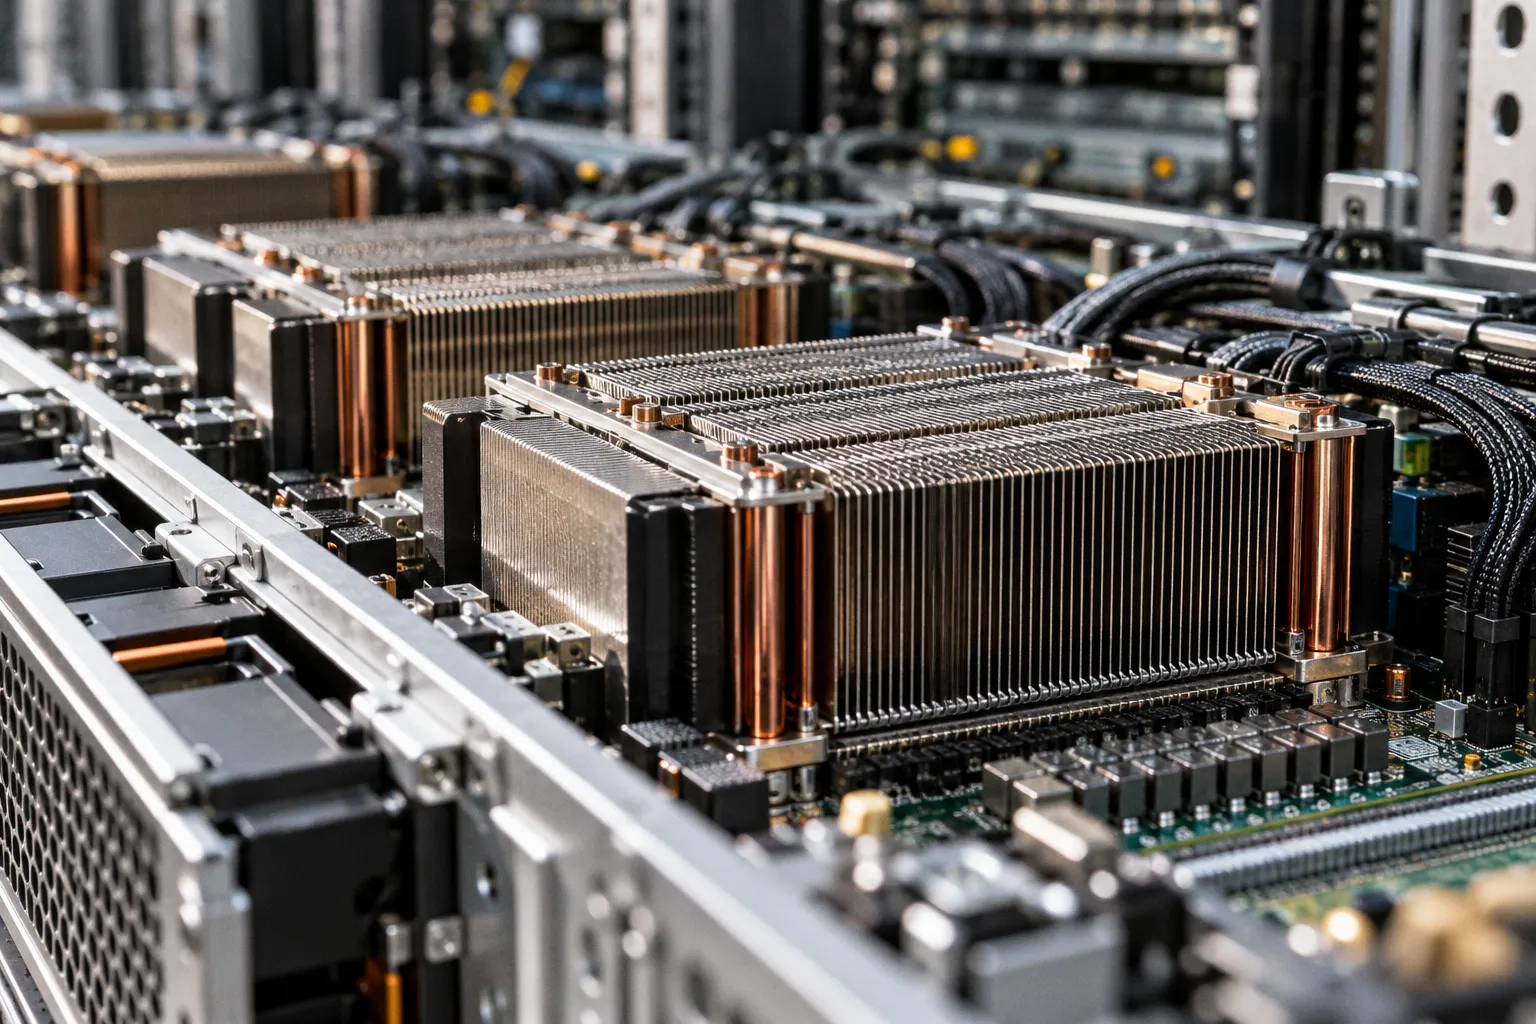
Это первая крупная отечественная языковая модель в публичной хронике.
Формулировка «российская нейросеть, созданная с нуля» не выдерживает проверки. Базовая архитектура ruGPT-3 была адаптирована из GPT-3 OpenAI. Обучение, вычислительная инфраструктура и команда разработки принадлежали российским специалистам, но полный состав корпуса не раскрывался: подтвердить по опубликованным данным, что он целиком состоял из русскоязычных текстов, невозможно.
Тогда речь шла о базовой авторегрессионной модели. GigaChat и YandexGPT появились заметно позже, в 2023 году. Между ними прошли масштабирование параметров, эксперименты с корпусами, переход к открытым лицензиям и появление полноценных диалоговых сервисов.
История отечественного ИИ определяется тремя величинами: объёмом обучающих данных, числом настраиваемых весов и стоимостью вычислений. Их изменение даёт более точное представление о развитии технологии, чем список продуктовых релизов.
Что считать первой отечественной языковой моделью
Под языковой моделью понимается программная система, обученная воспроизводить статистические закономерности естественного языка. Во время обучения она получает последовательности токенов и учится оценивать вероятность следующего токена. Во время генерации этот механизм повторяется: модель получает текст, выбирает продолжение и добавляет его в контекст.
Параметры — это веса, которые модель изменяет в ходе обучения. Число 760 млн у ruGPT-3 Large означает объём настраиваемой численной модели. Оно не равно числу фактов, которые модель «выучила», и не задаёт качество ответа напрямую.
Формулировка «первая» требует уточнения по масштабу и доступности. Речь идёт о первой крупной отечественной генеративной модели, чьи веса были выложены в публичный доступ. Ранние авторегрессионные системы и экспериментальные языковые модели существовали раньше, но их публичная история не сопоставима по размеру с ruGPT-3 Large.
Базовую модель также необходимо отделять от чат-бота. В 2020 году пользователь получал модель, способную продолжать текст. Диалоговый сервис требует дополнительного слоя: обучения на инструкциях, обработки системного промпта, безопасности, инструментов, API, маршрутизации запросов и наблюдения за качеством ответов. GigaChat — продукт поверх языковой модели, а не её исходный синоним.
Такая разница объясняет многие сравнения. Две модели с близким числом параметров могут вести себя по-разному из-за состава корпуса, токенизатора, длины контекста, методов дообучения и процедур оценки. Набор параметров описывает ёмкость. Поведение определяется всей обучающей и эксплуатационной системой.
«Кристофари»: вычислительная основа обучения
Для обучения ruGPT-3 Large использовался суперкомпьютер Сбера «Кристофари». Его вычислительный сегмент состоял из 75 узлов NVIDIA DGX-2, в каждом из которых работало по 16 ускорителей Tesla V100. Конфигурация давала 1 200 ускорителей V100.
Для обучения крупной модели одного ускорителя недостаточно. Вычисления распределяются между узлами: часть данных обрабатывается параллельно, результаты прямого и обратного проходов агрегируются, веса последовательно обновляются. Такая схема позволяет сократить время обучения, но требует скоростной связи между узлами, надёжного хранения чекпойнтов и точной синхронизации.
Механика обучения модели складывается из нескольких этапов.
1. Подготовка корпуса. Тексты очищаются от технического мусора, размечаются и преобразуются в токены. Состав корпуса влияет на словарь, стиль, тематические пробелы и устойчивость модели к определённым формам запросов.
2. Постановка обучающей задачи. Модель получает фрагмент последовательности и пытается предсказать следующий токен. Ошибка рассчитывается через функцию потерь.
3. Обновление весов. Градиентный спуск изменяет миллиарды или сотни миллионов параметров в зависимости от размера модели. Для базовой ruGPT-3 Large их было 760 млн.
4. Сохранение чекпойнтов. Состояние модели регулярно фиксируется, чтобы обучение можно было продолжить, перезапустить на другом кластере или использовать промежуточную версию.
Без корпуса и вычислительного кластера утверждение о «российском ИИ» остаётся политической формулировкой. ruGPT-3 была конкретным обучением конкретной модели на конкретной инфраструктуре.
Точная стоимость электроэнергии и аренды мощностей для начального обучения ruGPT-3 Large официально не раскрывалась. Полный пофайловый состав первого коммерческого корпуса также оставался закрытым, включая данные, включённые по лицензиям и ограничениям авторских прав.
Поэтому параметры ruGPT-3 Large показывают масштаб модели, но не полную стоимость её создания. Обучение включало хранение корпуса, обработку данных, повторяемые эксперименты, квалификацию инженеров, электричество и амортизацию оборудования. Большинство этих составляющих не сведено в опубликованную итоговую сумму.
От 760 млн до 100 млрд: две конкурирующие линии моделей
В январе 2021 года Сбер представил ruGPT-3 XL с 1,3 млрд параметров. Это прямой шаг по масштабу относительно версии Large. Однако число параметров само по себе не определяет качество генерации: изменение корпуса, обучающих процедур и настроек оптимизации способно дать иной результат при сопоставимом размере модели.
В июне 2022 года «Яндекс» опубликовал YaLM 100B — открытую модель со 100 млрд параметров под лицензией Apache 2.0. Обучение заняло 65 дней на 800 видеокартах NVIDIA A100. Объём корпуса составлял примерно 1,7–2 ТБ.
Это принципиально другой класс вычислительной нагрузки. YaLM не развивала ruGPT: модели принадлежат конкурирующим разработчикам. Их можно сравнивать по доступности весов, лицензии, инфраструктуре и результатам собственных оценок, но истории релизов нельзя выстраивать как одну непрерывную ветку.
В июле 2023 года Сбер открыл базовую модель ruGPT-3.5 13B под лицензией MIT. Её контекстное окно составляло 2048 токенов. Для pretraining использовался текстовый корпус размером около 1 ТБ, включавший новостные базы и корпус кода The Stack. Эта модель стала фундаментом GigaChat. В той же размерной линии Сбер использовал обозначение mGPT 13B для многоязычной ветки.
| Модель | Дата публичного релиза | Параметры | Зафиксированные особенности |
|---|---|---|---|
| ruGPT-3 Large | Октябрь 2020 | 760 млн | Обучение на «Кристофари», 75 узлов DGX-2 по 16 Tesla V100 |
| ruGPT-3 XL | Январь 2021 | 1,3 млрд | Масштабирование ранней русскоязычной линейки Сбера |
| YaLM 100B | Июнь 2022 | 100 млрд | 65 дней, 800 NVIDIA A100, корпус примерно 1,7–2 ТБ, Apache 2.0 |
| ruGPT-3.5 13B | Июль 2023 | 13 млрд | MIT, контекст 2048 токенов, корпус около 1 ТБ, основа GigaChat |
Сравнение таблицы показывает важный перекос. YaLM 100B обладает большим числом параметров, однако это ещё ничего не говорит об универсальном превосходстве над ruGPT-3.5 13B. Две модели используют разные корпуса, инфраструктуру, методы обучения и критерии оценки. Без воспроизводимых тестов по одинаковым задачам число параметров остаётся описанием архитектуры.
Масштаб языковой модели показывает объём памяти весов. Качество определяется корпусом, оптимизацией, дообучением и методикой оценки.
Открытая лицензия меняет доступ к модели, но не устраняет её стоимость. Весовая матрица на 100 млрд параметров требует серьёзной вычислительной системы. Apache 2.0 и MIT снимают часть ограничений на использование, воспроизведение и модификацию, оставляя инженерные расходы прежними.
Датасет, лицензия и границы доступности
Корпус определяет не только тематику модели. Он задаёт словарь, стилистические предпочтения, уровень специальных знаний и набор устойчивых ошибок. Новостные тексты, код и пользовательские публикации дают разный сигнал. Один тип данных может улучшать работу с терминологией, другой размывает распределение языка.
Пример доменной области — каталог полезных рецептов, ПП-меню, продуктов и привычек питания. Для индексации здесь полезны не общие слова о здоровье, а структурированные инструкции, составы, сезонные подборки и связи между блюдом и нутриентом. На таком материале модель связывает запрос с конкретным объектом вместо ограничений общими рекомендациями.
Объём корпуса в терабайтах сам по себе не гарантирует качество. Дубликаты, устаревшие документы, дисбаланс языков и неверная разметка способны снизить результат. При этом полный состав коммерческого корпуса ruGPT-3 Large оставался закрытым. Его размер и происхождение невозможно воспроизвести независимо.
Датасет и память модели существуют на разных этапах. После pretraining обучающая выборка обычно недоступна сервису во время запроса. Модель использует закономерности, записанные в весах, и текст текущего контекста. Чтобы работать со свежими документами, систему дополняют поиском по базе знаний и добавляют найденные фрагменты в запрос. Такой подход называется retrieval-augmented generation, или RAG.
Для ruGPT-3.5 13B окно в 2048 токенов задавало жёсткую границу объёма входной и выходной информации. Токен отличается от слова: длина текста в символах, словах и токенах различается. При росте диалога или загрузке документов часть контекста вытесняется либо сокращается. RAG, внешние инструменты и отдельный слой памяти решают эту инженерную задачу.
Лицензия определяет второй контур ограничений. Закрытая модель может работать только через API конкретного поставщика. Открытые веса позволяют разместить модель в собственной инфраструктуре, дообучать её и контролировать обработку запросов. Полный стек воспроизводимости требует дополнительно:
- исходного или реконструируемого корпуса;
- кода pretraining и инференса;
- адаптера для выбранного ускорителя;
- процедур оценки и контроля качества;
- мониторинга стоимости, задержек и отказов.
Открытие весов закрывает лицензионный барьер. Оно не делает проект воспроизводимым: для запуска по-прежнему нужен вычислительный бюджет.
От базовой модели к GigaChat
GigaChat работает поверх ruGPT-3.5 13B, но воспринимать эти названия как синонимы ошибочно. Языковая модель выполняет базовую задачу генерации. Продукт добавляет несколько уровней обработки.
На уровне диалога модель обучают или дообучают на примерах вопросов, инструкций, ответов и многошаговых задач. Сервисный слой задаёт формат сообщений, роль ассистента и правила обработки системных указаний. Безопасность реализуется через правила, классификаторы, ограничения и мониторинг. Инструменты позволяют вызывать внешние API, искать данные и выполнять действия за пределами сгенерированного текста.
Отдельная инфраструктура решает эксплуатационные задачи: распределяет запросы, кэширует часто используемые части системы, ограничивает нагрузку, отслеживает задержки и стоимость. Для пользователя важен ответ. Для разработчика важнее его воспроизводимость, контроль качества и предсказуемая работа при изменении нагрузки.
YandexGPT, появившийся в 2023 году, развивался в конкурирующей линии «Яндекса». Объединение GigaChat и YandexGPT в одну последовательность релизов создаёт ложную картину. YaLM 100B, ruGPT-3.5 и YandexGPT — разные модели с разными архитектурными линиями, лицензиями и инфраструктурными решениями.
Качество таких систем измеряется наборами тестов. Для поискового ответа важны фактическая точность, полнота и соответствие запросу. Для диалога — устойчивость инструкций, отсутствие нежелательного поведения и способность признавать ограничения. Для сервиса — задержка, стоимость обработки, доступность и предсказуемость. Даже удачный демонстрационный диалог не заменяет систематической оценки.
Импортозамещение нейросетей в этой части истории выглядит конкретно: открытые лицензии YaLM 100B и ruGPT-3.5 13B, отечественная вычислительная инфраструктура и появление сервисов поверх отечественных моделей. Одновременно остаются инженерные ограничения: стоимость обучения и инференса, качество корпуса, поддержка ускорителей, безопасность, мониторинг и эксплуатационная надёжность.
Хронология от ruGPT-3 Large до YaLM 100B и GigaChat показывает последовательное усложнение системы. В 2020 году фиксировали сотни миллионов весов и обучение на «Кристофари». В 2021-м увеличивали масштаб до 1,3 млрд параметров. В 2022-м открывали стомиллиардную модель с лицензией Apache 2.0. В 2023-м выпускали 13-миллиардную основу для диалогового сервиса.
Главный результат этой истории заключается в переходе от изолированного эксперимента к воспроизводимой инфраструктуре: открытые веса, документированные условия обучения, вычислительные кластеры и сервисный слой. Параметры остаются заметными, однако в приоритете оказываются корпус, инфраструктура, методики оценки и стоимость эксплуатации.